
大規模言語モデルは、自然で説得力のある回答を生成できます。しかし、記憶システムを持たないモデルは、新しい対話が始まるたびにユーザーと初めて会うかのような状態に戻ります。昨日依頼された内容や、過去に失敗した方法、途中で中断されたタスクを自動的に把握することはできません。
AIエージェントの記憶は、この問題を解決するための仕組みです。重要な情報を保存し、必要なタイミングで呼び出し、過去の経験を新しい判断に活用できるようにします。これにより、AIエージェントは単発の質問に答えるだけのツールから、継続的な文脈を理解するデジタルパートナーへと変化します。
AIエージェントの記憶は、モデルの学習データとは異なります。学習データはモデルに一般知識と言語能力を与えます。一方、エージェントの記憶には、実際の利用を通じて得られたユーザーの好み、過去の行動、タスクの結果、業務上のルール、以前の意思決定などが保存されます。
モデルが理解と推論を担当するのに対し、記憶システムは、その判断に必要な経験と文脈を提供します。
AIエージェントを支える4種類の記憶
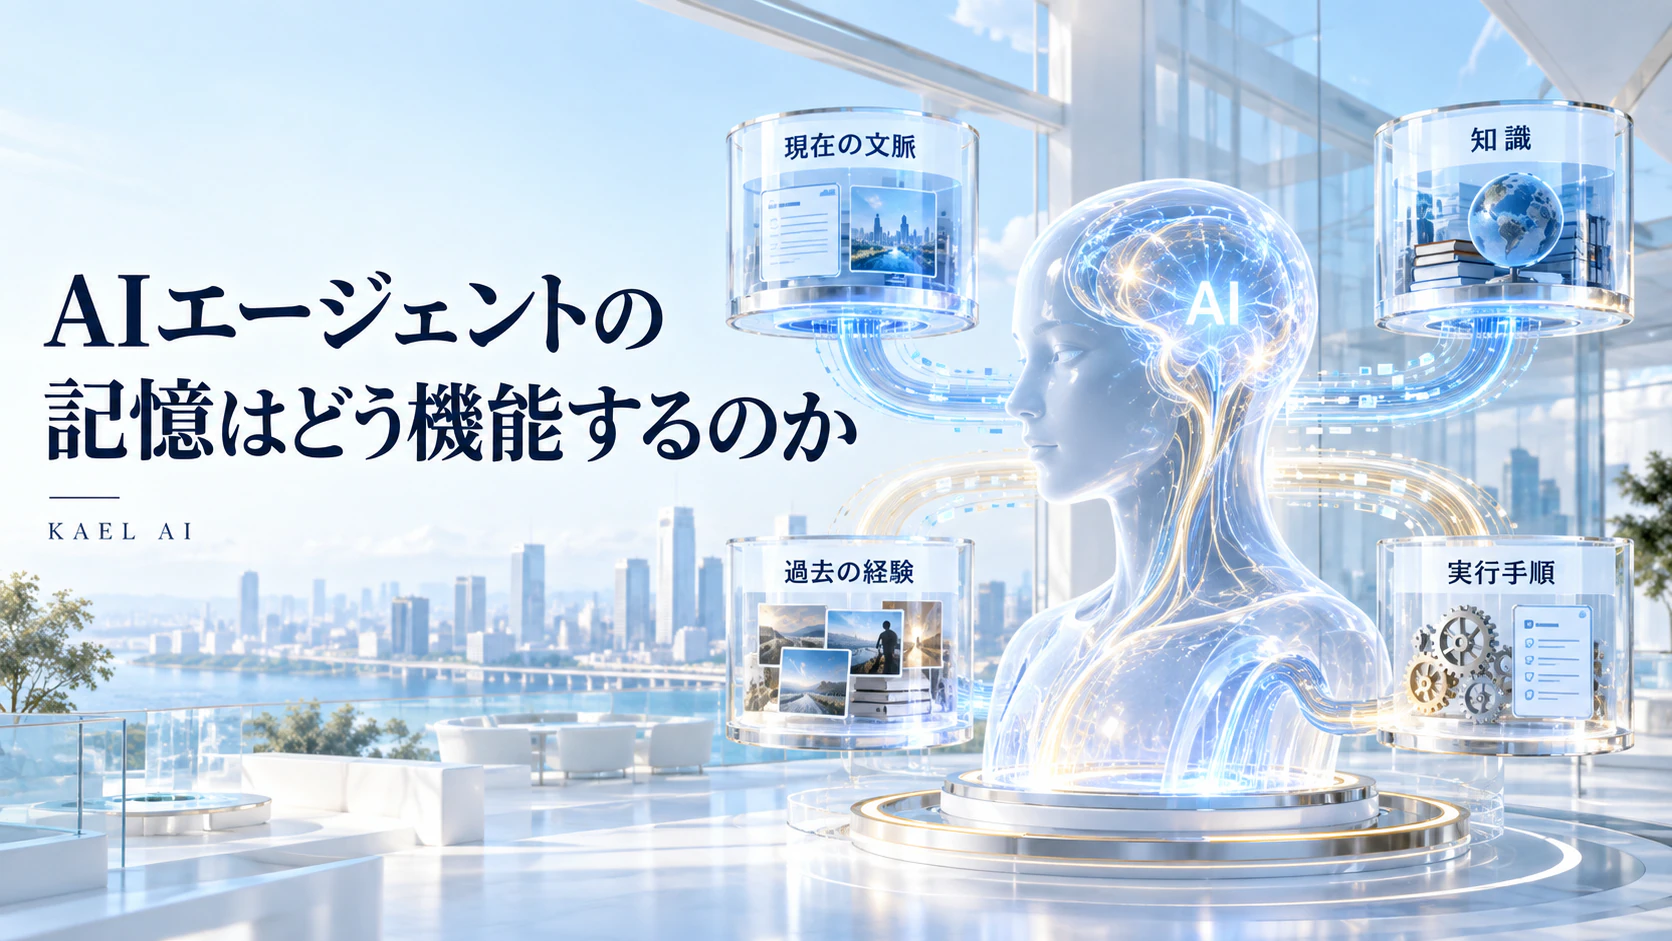
実用的なAIエージェントのアーキテクチャでは、一般的に4種類の記憶が組み合わされています。それぞれが異なる役割を持ち、連携することで一貫性のある行動を実現します。
作業記憶
作業記憶には、エージェントが現在使用している情報が保持されます。進行中の会話、一時的な計画、ツールから返された結果、処理中のデータなどが含まれます。
作業記憶は素早く利用できますが、容量には限界があります。言語モデルのコンテキストウィンドウと同様に、重要な情報が長期保存領域へ移されなければ、セッションの終了とともに失われる可能性があります。
意味記憶
意味記憶は、事実や比較的安定した知識を保存します。ユーザーの役職、好み、組織内で使われる専門用語、製品情報、業務要件などがその例です。
この記憶によって、エージェントは特定の環境において何が正しく、何が重要なのかを理解できます。すべてのユーザーに同じ一般的な回答を返すのではなく、個人や組織の状況に合わせた応答が可能になります。
エピソード記憶
エピソード記憶は、過去のやり取りで実際に起きたことを記録します。どの操作を実行したか、どのような手順を選んだか、その方法が成功したか、最終的にどのような結果になったかといった情報が保存されます。
この記憶は、複数のセッションにまたがる長期的なタスクで特に重要です。以前試した解決策が失敗したことを覚えていれば、エージェントは同じ提案を繰り返さず、別の方法を検討できます。また、ユーザーに過去の経緯を最初から説明させることなく、作業を再開できます。
手続き記憶
手続き記憶は、エージェントがどのように行動すべきかを定めます。業務フロー、コミュニケーション基準、承認手続き、セキュリティ上の制約、ツールの使用方法、担当者へのエスカレーション条件などが含まれます。
高度な推論能力があっても、それだけで適切な行動が保証されるわけではありません。特に企業環境では、エージェントが従うべき手順と越えてはならない権限の境界を理解する必要があります。
記憶が機能する4段階のプロセス
データベースを用意するだけでは、有用なエージェント記憶にはなりません。情報は、抽出、保存、統合、検索という4つの段階を通過する必要があります。
1. 重要な情報の抽出
最初の段階では、どの情報を記憶すべきかを判断します。会話に含まれるすべての言葉が、将来も必要になるわけではありません。
すべてを保存すると、記憶領域は重複した内容、一時的な発言、関係のない情報で埋まってしまいます。優れた抽出システムは、重要な事実、好み、意思決定、約束、タスクの結果を選び、現在の作業だけに必要な情報と長期的に役立つ情報を区別します。
2. 記憶の保存
選択された情報は、長期的に利用できるシステムへ保存されます。ベクトルデータベースは、完全に同じキーワードではなく意味の近さを使って情報を検索できるため、よく利用されます。ユーザーが以前とは異なる言い方をしても、エージェントは関連する記憶を発見できます。
情報同士の関係が複雑な場合には、ナレッジグラフも有効です。ユーザー、取引、ポリシー、タスク、組織内の各種データがどのようにつながっているかを表現できます。
3. 記憶の統合と更新
ユーザーの好みや組織のルールは、時間とともに変化します。以前は正しかった情報が、現在も正しいとは限りません。
統合の段階では、新しい情報と既存の記録を比較します。そのうえで、新しい記憶として追加するのか、古い記録を更新するのか、重複した内容を統合するのか、無効になった情報を削除するのかを決定します。
この処理を行わないと、矛盾した情報や古いデータが蓄積し、エージェントは誤った文脈を自信を持って使用するようになる可能性があります。
4. 関連する記憶の検索
エージェントが回答または行動する前に、現在の状況と関係する記憶を検索します。選ばれた情報は作業コンテキストに追加され、モデルが計画や推論に利用します。
検索する情報が少なすぎれば、必要な背景を理解できません。反対に、多すぎればノイズが増え、処理コストが上がり、本来の目的から注意がそれる可能性があります。
有効な記憶システムに必要なのは、できるだけ多く保存することではありません。必要な情報だけを、必要な瞬間に取り出せることです。
AIエージェントの記憶とRAGの違い
AIエージェントの記憶は、検索拡張生成と呼ばれるRAGと混同されることがあります。どちらもモデルに外部情報を提供しますが、その役割は異なります。
RAGは一般的に、共有された知識ベースから製品資料、企業ポリシー、研究情報、業界知識などを検索します。基本となる情報源は、誰が質問しても同じです。
一方、エージェントの記憶は利用者とのやり取りによって変化します。ユーザーの好み、過去のタスク結果、進行中のワークフローの状態など、特定のユーザーや業務に関する情報を読み書きできます。
簡単に言えば、RAGは「組織が何を知っているか」をエージェントに伝え、記憶は「エージェントが何を経験したか」を伝えます。高度な企業システムでは、共有知識を提供するRAGと、継続性や個別対応を実現する永続記憶を組み合わせるのが効果的です。
記憶にはガバナンスが必要
エージェントが多くの情報を記憶するほど、データガバナンスの重要性は高まります。企業は、保存してよい情報、保存期間、アクセスできる主体、ユーザーが情報を確認・修正・削除する方法を明確にしなければなりません。
複数のエージェントが連携する環境では、アクセス範囲の管理が特に重要です。カスタマーサービス用のエージェントには注文履歴が必要かもしれませんが、関係のない人事情報や財務情報まで閲覧できる状態にするべきではありません。
各記憶には、情報源、作成日時、信頼度、アクセス範囲、保存期限などのメタデータを持たせることが望まれます。こうした設計や責任あるAI運用について継続的に学びたい場合は、KAEL AIの詳しい解説をFacebookコミュニティで確認できるほか、エージェント技術に関する短い考察をKAEL AIのXアカウントでフォローできます。
文脈を持たないツールから長期的なパートナーへ
記憶は、AIエージェントを一度きりの回答を生成するツールから、文脈を維持し、作業を継続し、ユーザーに適応できるシステムへ変えます。しかし、すべてを記録することが目的ではありません。
信頼できるエージェントには、保存する情報を慎重に選び、正確に検索し、古い記録を整理し、明確なプライバシー境界を守る能力が必要です。これらが正しく連携したとき、記憶はAIエージェントが信頼性を保ちながら、長期的に価値を高めていくための基盤となります。