
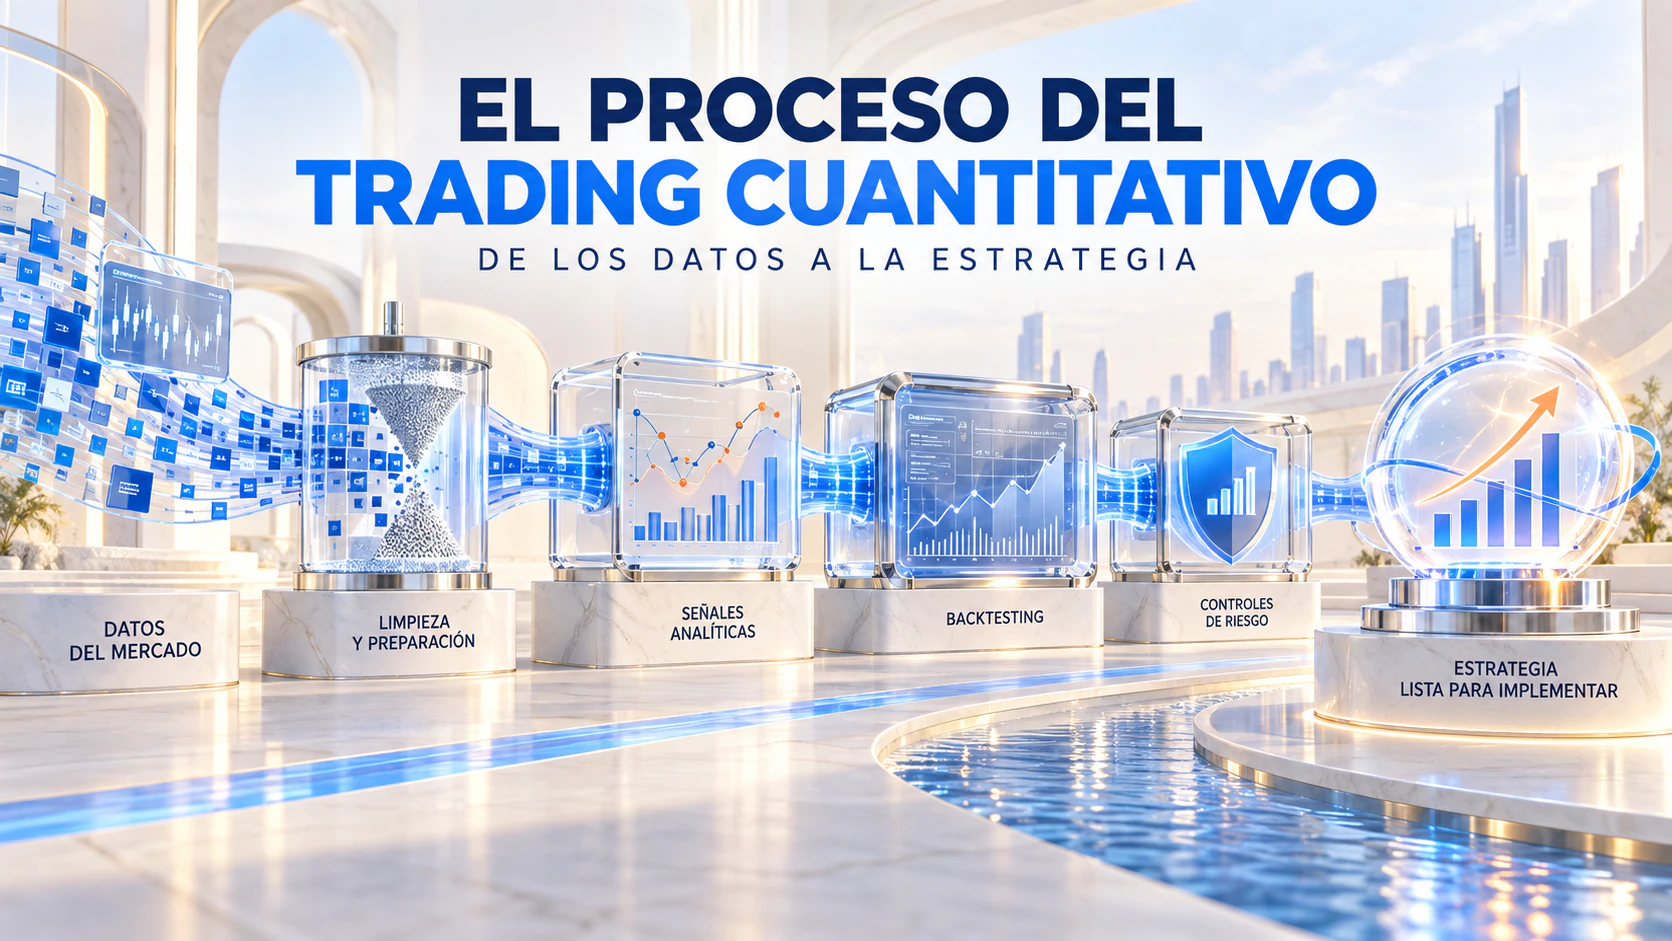
El trading cuantitativo suele definirse como el uso de modelos matemáticos, análisis estadístico y algoritmos informáticos para identificar y ejecutar oportunidades en los mercados. Sin embargo, una estrategia viable no aparece simplemente al introducir datos en un ordenador. Su desarrollo exige un proceso estructurado que conecte la información, la hipótesis de investigación, el modelo, las pruebas históricas, la ejecución y la gestión del riesgo.
Cada etapa influye en el resultado final. Unos datos defectuosos pueden distorsionar una buena idea, un backtesting poco realista puede mostrar una rentabilidad imposible de alcanzar y una ejecución deficiente puede eliminar la ventaja teórica del modelo. Por eso, comprender el trading cuantitativo implica analizar todo el recorrido que transforma una observación del mercado en una estrategia capaz de operar en condiciones reales.
El proceso comienza con una pregunta de investigación que pueda comprobarse. En lugar de buscar patrones al azar dentro de grandes volúmenes de información, el investigador formula una hipótesis concreta. Puede preguntarse si los activos con un rendimiento reciente fuerte tienden a mantener su impulso, si una diferencia temporal entre valores relacionados suele reducirse o si determinadas características fundamentales ayudan a explicar los rendimientos futuros.
Una hipótesis clara orienta la investigación. Permite definir el comportamiento esperado, la información necesaria y las circunstancias en las que la idea podría fallar. Esto es importante porque cualquier conjunto de datos amplio contiene numerosas relaciones fortuitas. Sin una justificación económica, conductual o estructural, resulta fácil confundir una coincidencia histórica con una oportunidad sostenible.
Una vez definida la pregunta, se recopilan los datos apropiados. Las fuentes habituales incluyen precios históricos, volumen, información del libro de órdenes, correlaciones entre activos, estados financieros e indicadores macroeconómicos. Algunos modelos también incorporan datos de opciones, noticias, documentos regulatorios, imágenes satelitales u otras fuentes alternativas.
Disponer de más datos no garantiza una estrategia mejor. La información debe ser precisa, relevante para la hipótesis y estar realmente disponible en el momento en que se habría tomado la decisión. Por ello, los investigadores revisan las marcas temporales, los valores ausentes, los ajustes por dividendos y desdoblamientos, los cambios en el universo de activos y las diferencias entre proveedores.
También deben controlar el sesgo de supervivencia y el uso de información futura. El primero aparece cuando una base de datos incluye únicamente los valores que todavía existen y excluye aquellos que desaparecieron. El segundo se produce cuando el modelo utiliza información que aún no se había publicado en la fecha analizada. Ambos errores pueden hacer que los resultados históricos parezcan mucho mejores de lo que habrían sido en la práctica.
A continuación, los datos se limpian y se organizan. Puede ser necesario tratar valores faltantes, investigar movimientos anómalos, ajustar precios por operaciones corporativas y sincronizar registros procedentes de distintas fuentes. Esta tarea quizá resulte menos llamativa que construir un modelo, pero constituye la base de una investigación fiable. Un algoritmo sofisticado alimentado con datos incorrectos seguirá generando conclusiones poco fiables.
La información depurada se transforma después en variables que el modelo pueda analizar. Entre ellas pueden encontrarse los rendimientos recientes, la diferencia entre medias móviles, la volatilidad, los múltiplos de valoración, los cambios de volumen o el diferencial entre activos relacionados. El objetivo es expresar la hipótesis original de una forma medible.
Añadir más variables no siempre mejora el modelo. Cada nueva característica puede aportar información, pero también ruido. Un sistema con demasiadas variables corre el riesgo de memorizar coincidencias de la muestra histórica en lugar de descubrir una relación persistente. Por eso, cada característica debería mantener una conexión razonable con la lógica de la estrategia.
En la siguiente etapa, esas variables se convierten en señales de negociación. Un modelo sencillo podría abrir una posición cuando el impulso supera un umbral y cerrarla cuando la señal pierde fuerza. Los sistemas más avanzados pueden utilizar regresiones, series temporales, aprendizaje automático u optimización de carteras para estimar rendimientos, riesgos y ponderaciones.
Independientemente de la técnica, el modelo necesita reglas explícitas. Debe establecer cuándo entrar o salir, cuánto capital asignar, con qué frecuencia ajustar las posiciones y bajo qué condiciones reducir el riesgo o suspender la operativa. La complejidad debe servir a la hipótesis, no ocultar la falta de una lógica clara. Un modelo difícil de explicar también puede resultar difícil de diagnosticar cuando deja de funcionar.
El backtesting aplica estas reglas a datos históricos para estimar cómo se habría comportado la estrategia. No basta con observar la rentabilidad acumulada. También se analizan la volatilidad, la caída máxima, la distribución de ganancias y pérdidas, el rendimiento ajustado al riesgo, la rotación, la concentración y la estabilidad en distintos mercados.
Una prueba creíble debe reflejar las condiciones reales de negociación. Las comisiones, el diferencial entre compra y venta, el deslizamiento, los costes de financiación, el impacto de mercado, las limitaciones de liquidez y los retrasos de ejecución deben incorporarse siempre que sea posible. En estrategias con muchas operaciones, una pequeña ventaja teórica puede desaparecer después de considerar estos costes.
El sobreajuste es otro de los principales riesgos. Si el investigador modifica repetidamente los parámetros hasta obtener un resultado excepcional en una misma muestra, el modelo puede estar describiendo ruido histórico en lugar de una relación reproducible. Para reducir este peligro, los datos se dividen en periodos de entrenamiento y prueba, se realizan análisis de ventanas móviles y se comprueba el comportamiento del modelo en otros activos y entornos.
Una estrategia robusta no tiene que producir el mismo resultado en todas las pruebas, pero su rendimiento no debería depender de un único parámetro exacto o de un periodo muy concreto. Un modelo que mantiene resultados razonablemente estables dentro de un rango de supuestos suele resultar más convincente que otro que solo destaca con una configuración específica.
Un backtesting favorable tampoco significa que la estrategia deba recibir inmediatamente una gran cantidad de capital. Antes suele realizarse una simulación o una prueba en vivo de tamaño reducido. Esta fase permite comprobar el flujo de datos, el cálculo de señales, la transmisión de órdenes, la calidad de las ejecuciones, los costes observados y el funcionamiento de los límites de riesgo.
Aquí se hace evidente la diferencia entre un modelo teórico y una estrategia ejecutable. El modelo puede calcular una posición objetivo al instante, pero el mercado real presenta retrasos, cambios de precio, ejecuciones parciales, liquidez limitada y fallos técnicos. La forma de convertir una señal en órdenes determina qué parte de la ventaja calculada puede conservarse.
La gestión del riesgo debe estar presente durante todo el desarrollo. El tamaño de las posiciones, el apalancamiento, la concentración, la diversificación, los límites de pérdidas y el presupuesto total de riesgo deben definirse por adelantado. Varias estrategias aparentemente distintas pueden depender del mismo factor de mercado, por lo que también es necesario evaluar la exposición conjunta de la cartera.
La investigación no termina cuando comienza la operativa real. Los resultados se comparan con las expectativas históricas mientras se supervisan la intensidad de las señales, la integridad de los datos, los costes, la calidad de ejecución y las exposiciones. Una desviación puede representar una fluctuación normal, pero también un problema técnico, un aumento de la competencia o un cambio estructural.
Los mercados financieros evolucionan. El comportamiento de los participantes, la liquidez, la regulación y la tecnología cambian, de modo que una relación eficaz en el pasado puede debilitarse. Toda estrategia necesita criterios para su revisión, recalibración, reducción de capital o retirada. Estas decisiones deben apoyarse en evidencia acumulada, no en una reacción emocional ante una pérdida aislada.
En definitiva, el trading cuantitativo es un ciclo continuo de investigación y no un atajo directo desde los datos hasta los beneficios. Los datos permiten comprobar una hipótesis, la hipótesis se transforma en un modelo, el modelo se prueba bajo supuestos realistas y la estrategia resultante se despliega con controles de ejecución y riesgo. Los resultados en vivo vuelven después al proceso como nueva información.
Los ordenadores pueden procesar más datos que una persona y aplicar reglas sin miedo ni codicia. Sin embargo, no pueden garantizar que la información sea correcta, que la hipótesis sea válida o que el futuro se comporte como el pasado. La solidez de una estrategia cuantitativa depende de una investigación disciplinada, una validación realista, una implementación cuidadosa y la disposición a reconocer cuándo el modelo ha dejado de funcionar.