
Actualités KAEL
Le processus du trading quantitatif : des données à la stratégie
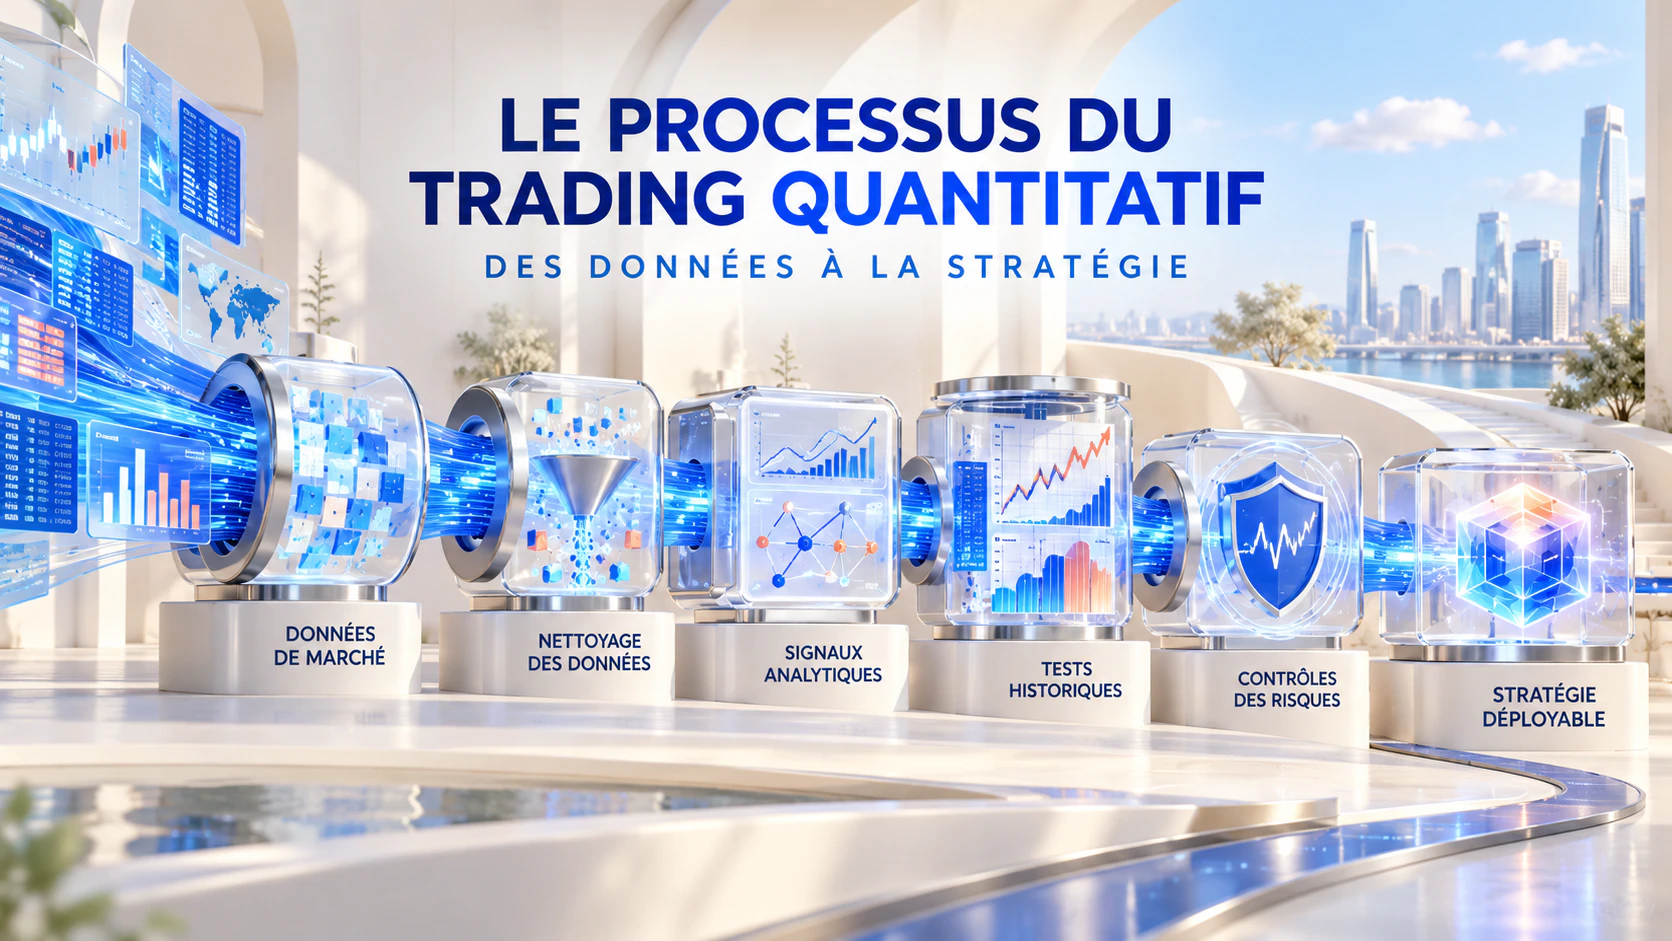
Le trading quantitatif est généralement défini comme l’utilisation de modèles mathématiques, de méthodes statistiques et d’algorithmes informatiques afin d’identifier et d’exécuter des opportunités de marché. Pourtant, une stratégie exploitable ne naît pas simplement de l’introduction de données dans un ordinateur. Sa création repose sur un processus structuré reliant les données, l’hypothèse de recherche, la modélisation, les tests historiques, l’exécution et la gestion des risques.
Chaque étape influence le résultat final. Des données défectueuses peuvent déformer une bonne idée, un backtest irréaliste peut afficher une performance impossible à reproduire et une mauvaise exécution peut faire disparaître l’avantage théorique du modèle. Comprendre le trading quantitatif suppose donc d’étudier tout le parcours qui transforme une observation du marché en stratégie capable de fonctionner dans des conditions réelles.
Le processus commence par une question de recherche vérifiable. Au lieu de chercher au hasard des motifs dans d’immenses volumes d’informations, le chercheur formule une hypothèse précise. Il peut se demander si les actifs affichant une forte performance récente ont tendance à poursuivre leur mouvement, si un écart temporaire entre deux titres liés finit par se résorber ou si certaines caractéristiques fondamentales permettent d’expliquer les rendements futurs.
Une hypothèse claire donne une direction à la recherche. Elle précise le comportement attendu, les informations nécessaires et les circonstances dans lesquelles l’idée pourrait échouer. Cette discipline est essentielle, car les grands ensembles de données contiennent inévitablement des relations fortuites. Sans justification économique, comportementale ou structurelle, une coïncidence historique peut facilement être confondue avec une opportunité durable.
Une fois la question définie, il faut réunir les données appropriées. Les sources courantes comprennent les prix historiques, les volumes, le carnet d’ordres, les corrélations entre actifs, les états financiers et les indicateurs macroéconomiques. Certains modèles utilisent également les données d’options, les actualités, les documents réglementaires, les images satellites ou d’autres données alternatives.
Un volume d’informations plus important ne garantit toutefois pas une meilleure stratégie. Les données doivent être exactes, pertinentes et réellement disponibles au moment où la décision historique aurait été prise. Les chercheurs vérifient donc les horodatages, les observations manquantes, les ajustements liés aux dividendes et aux fractionnements d’actions, les changements de composition de l’univers étudié et les différences entre fournisseurs.
Le biais de survie et le biais d’anticipation exigent une attention particulière. Le premier apparaît lorsqu’une base ne contient que les actifs encore présents aujourd’hui et exclut ceux qui ont disparu. Le second se produit lorsqu’un modèle utilise une information qui n’était pas encore publiée à la date étudiée. Ces deux erreurs peuvent considérablement surestimer les performances historiques.
Les données collectées doivent ensuite être nettoyées et organisées. Il peut être nécessaire de traiter les valeurs manquantes, d’examiner les mouvements anormaux, d’ajuster les prix après des opérations sur titres et d’aligner les enregistrements issus de plusieurs sources. Ce travail est moins visible que la modélisation, mais il constitue le socle d’une recherche fiable. Un algorithme sophistiqué alimenté par des informations erronées produira toujours des conclusions fragiles.
Les données nettoyées sont alors transformées en variables que le modèle peut analyser. Il peut s’agir des rendements récents, de l’écart entre des moyennes mobiles, de la volatilité, de ratios de valorisation, de variations de volume ou du spread entre des actifs liés. L’objectif est de représenter l’hypothèse initiale sous une forme mesurable.
Ajouter davantage de variables n’améliore pas nécessairement le modèle. Chaque nouvelle caractéristique peut apporter une information utile, mais également du bruit. Un système utilisant trop de variables risque de mémoriser les particularités accidentelles de l’échantillon plutôt que de détecter une relation persistante. Chaque caractéristique devrait donc conserver un lien explicable avec la logique de la stratégie.
L’étape suivante consiste à convertir ces variables en signaux de trading. Un modèle simple peut ouvrir une position lorsque le momentum franchit un seuil, puis la clôturer quand le signal faiblit. Des systèmes plus avancés utilisent la régression, l’analyse des séries temporelles, l’apprentissage automatique ou l’optimisation de portefeuille pour estimer les rendements, les risques et les allocations.
Quelle que soit la technique choisie, le modèle doit contenir des règles précises. Il faut définir les conditions d’entrée et de sortie, le capital alloué, la fréquence de rééquilibrage et les circonstances imposant une réduction du risque ou un arrêt des opérations. La complexité doit servir l’hypothèse et non masquer l’absence de logique. Un modèle difficile à expliquer sera également difficile à diagnostiquer lorsqu’il cessera de fonctionner.
Le backtesting applique ces règles aux données historiques afin d’estimer le comportement de la stratégie dans différents environnements. Le rendement cumulé ne suffit pas. Les chercheurs examinent également la volatilité, la perte maximale, la distribution des gains et des pertes, la performance ajustée du risque, la rotation, la concentration et la stabilité selon les régimes de marché.
Un test crédible doit refléter les contraintes réelles. Les commissions, l’écart acheteur-vendeur, le glissement de prix, les coûts d’emprunt, l’impact de marché, les limites de liquidité et les délais d’exécution doivent être intégrés autant que possible. Pour une stratégie très active, un faible avantage théorique peut disparaître entièrement après prise en compte de ces coûts.
Le surapprentissage constitue un autre risque majeur. Si le chercheur modifie continuellement les paramètres jusqu’à obtenir un résultat exceptionnel sur le même échantillon, le modèle peut simplement décrire le bruit du passé. Pour limiter ce danger, les données sont divisées entre périodes d’entraînement et de test, des analyses glissantes sont réalisées et le modèle est évalué sur d’autres actifs et périodes.
Une stratégie robuste n’a pas besoin de produire exactement le même résultat lors de chaque test. Sa performance ne devrait toutefois pas dépendre d’un paramètre unique ou d’une courte phase de marché. Un modèle restant relativement stable dans une plage raisonnable d’hypothèses est généralement plus crédible qu’un modèle spectaculaire sous une seule configuration.
Un backtest favorable ne signifie pas non plus que la stratégie doit immédiatement recevoir un capital important. Les équipes commencent souvent par une simulation ou un déploiement réel de faible ampleur. Cette phase permet de contrôler les flux de données, le calcul des signaux, la transmission des ordres, la qualité des exécutions, les coûts observés et le fonctionnement des limites de risque.
La différence entre un modèle théorique et une stratégie exécutable devient alors évidente. Le modèle peut calculer instantanément une position cible, tandis que le marché réel impose des retards, des variations de prix, des exécutions partielles, une liquidité limitée et des incidents techniques. La manière de convertir le signal en ordre détermine la part de l’avantage théorique qui peut être conservée.
La gestion des risques doit être intégrée à l’ensemble du développement. La taille des positions, l’effet de levier, la concentration, la diversification, les seuils de perte et le budget global de risque doivent être définis à l’avance. Plusieurs stratégies apparemment différentes peuvent dépendre du même facteur de marché ; il faut donc évaluer les expositions au niveau du portefeuille.
La recherche ne se termine pas au lancement. Les performances réelles sont comparées aux attentes historiques, tandis que la force des signaux, l’intégrité des données, les coûts, la qualité d’exécution et les expositions sont surveillés. Un écart peut correspondre à une variation normale, mais aussi révéler un problème technique, une concurrence accrue ou une transformation structurelle du marché.
Les marchés financiers évoluent continuellement. Les comportements, la liquidité, la réglementation et les technologies changent, ce qui peut affaiblir une relation autrefois efficace. Chaque stratégie doit donc comporter des critères de révision, de recalibrage, de réduction du capital ou d’arrêt. Ces décisions doivent reposer sur des preuves accumulées, et non sur une réaction émotionnelle à une perte isolée.
Le trading quantitatif constitue ainsi un cycle continu de recherche plutôt qu’un raccourci direct entre les données et les profits. Les données servent à tester une hypothèse, l’hypothèse devient un modèle, le modèle est vérifié avec des hypothèses réalistes, puis la stratégie est déployée avec des contrôles d’exécution et de risque. Les résultats réels alimentent ensuite le prochain cycle de recherche.
Les ordinateurs peuvent traiter davantage d’informations qu’un être humain et appliquer des règles sans peur ni avidité. Ils ne peuvent cependant garantir l’exactitude des données, la validité de l’hypothèse ou la répétition du passé. La solidité d’une stratégie quantitative repose sur une recherche disciplinée, une validation réaliste, une mise en œuvre rigoureuse et la capacité à reconnaître qu’un modèle ne fonctionne plus.