
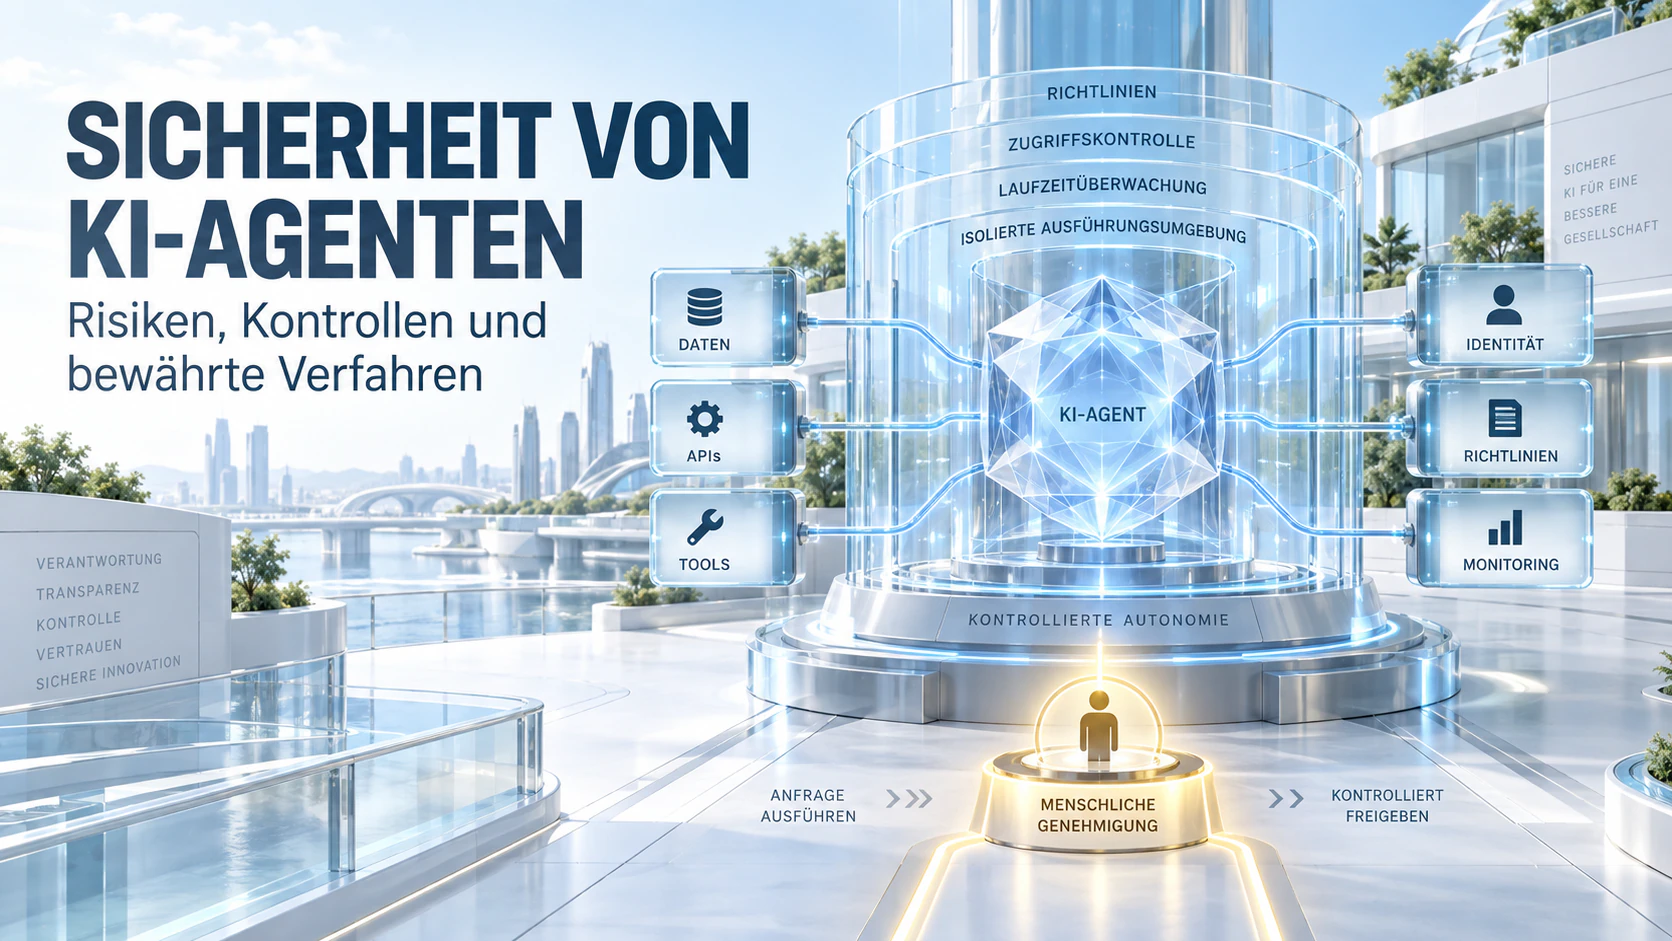
KI-Agenten entwickeln sich von einfachen Dialogsystemen zu digitalen Akteuren, die Ziele interpretieren, Pläne erstellen, auf Daten zugreifen, Softwarewerkzeuge verwenden und Aktionen im Namen von Nutzern ausführen können. Ein Agent kann Dokumente prüfen, Kundendaten aktualisieren, Nachrichten versenden, Programmcode verändern oder an einem Finanzprozess mitwirken.
Diese Fähigkeiten schaffen erheblichen betrieblichen Nutzen, vergrößern jedoch zugleich die möglichen Folgen von Fehlern, Manipulationen und unbefugten Zugriffen. Die Sicherheit von KI-Agenten darf sich deshalb nicht auf die Kontrolle der erzeugten Antworten beschränken. Sie muss auch Identität, Berechtigungen, Werkzeuge, Speicher, Datenverbindungen und Laufzeitverhalten des Agenten schützen.
Das Ziel besteht nicht darin, Autonomie vollständig zu verhindern. Stattdessen geht es um kontrollierte Autonomie: Der Agent soll innerhalb sichtbarer, überprüfbarer und technisch durchsetzbarer Grenzen effizient arbeiten können.
## Warum KI-Agenten zusätzliche Sicherheitskontrollen benötigen
Herkömmliche Anwendungen folgen in der Regel vorab festgelegten Codepfaden. KI-Agenten können dagegen den Kontext interpretieren und dynamisch entscheiden, welche Schritte oder Werkzeuge sie einsetzen. Ähnliche Anfragen können deshalb zu unterschiedlichen Plänen, Ergebnissen oder Handlungen führen.
Klassische Maßnahmen wie Authentifizierung, Autorisierung, Schwachstellenprüfung, Netzwerkschutz und sichere Softwareentwicklung bleiben unverzichtbar. Agentische Systeme benötigen jedoch zusätzliche Kontrollen für sprachbasierte Anweisungen, abgerufenen Kontext, langfristigen Speicher, Werkzeugauswahl und mehrstufige Ausführung.
Jede neue Integration erweitert die Angriffsfläche. Ein Agent mit Zugriff auf E-Mail, Cloud-Speicher, Quellcode, Kundendatenbanken und Finanzsysteme könnte diese Berechtigungen auf unerwartete Weise kombinieren. Sicherheit darf daher nicht nur prüfen, ob der Agent eine Verbindung herstellen kann. Sie muss auch berücksichtigen, was er erreichen möchte, welche Daten er verwendet und ob die geplante Aktion seinem genehmigten Zweck entspricht.
## Zentrale Sicherheitsrisiken für KI-Agenten
Prompt Injection gehört zu den wichtigsten Bedrohungen. Angreifer können schädliche Anweisungen nicht nur in eine direkte Eingabe, sondern auch in Webseiten, E-Mails, gemeinsame Dokumente, Supporttickets oder Datenbankeinträge einbetten.
Verarbeitet der Agent solche Inhalte, kann er nicht vertrauenswürdige Daten mit einer autorisierten Anweisung verwechseln. Ein erfolgreicher Angriff könnte ihn dazu bringen, seine Regeln zu ignorieren, geschützte Informationen offenzulegen oder ein verbundenes Werkzeug außerhalb des vorgesehenen Aufgabenbereichs zu verwenden. Das Risiko steigt erheblich, wenn der Agent reale Aktionen ausführen kann, anstatt lediglich Text zu erzeugen.
Übermäßige Berechtigungen stellen ein weiteres kritisches Problem dar. Um die Bereitstellung zu vereinfachen, erhalten Agenten mitunter weitreichendere Rechte, als sie für ihre tatsächliche Aufgabe benötigen. Wird ein privilegierter Agent manipuliert oder trifft er eine falsche Entscheidung, könnte er vertrauliche Datensätze abrufen, Produktionsdaten verändern, unzulässige Nachrichten versenden oder eine Transaktion auslösen.
Der unsichere Einsatz von Werkzeugen verwandelt einen Denkfehler in einen betrieblichen Schaden. Ein Agent kann das falsche Werkzeug auswählen, gefährliche Parameter übermitteln, eine Aktion zum falschen Zeitpunkt ausführen oder die Absicht des Nutzers missverstehen. Eine ungenaue Antwort lässt sich korrigieren; eine Datenlöschung oder Finanztransaktion kann dagegen nur schwer rückgängig gemacht werden.
Auch Datenlecks sind eine bedeutende Gefahr. Sie können entstehen, wenn ein Agent Informationen außerhalb der Nutzerberechtigungen abruft, Geheimnisse in seine Ausgabe aufnimmt, vertraulichen Kontext an einen externen Dienst sendet oder sensible Daten in unzureichend geschützten Protokollen speichert. Da Agenten mehrere Umgebungen verbinden, können Daten aus einer autorisierten Quelle unbeabsichtigt an ein nicht genehmigtes Ziel gelangen.
## Speichervergiftung und Risiken der Lieferkette
Bei einer Speicher- oder Kontextvergiftung fügt ein Angreifer falsche oder schädliche Informationen in Quellen ein, die der Agent für zukünftige Entscheidungen nutzt. Betroffen sein können der Langzeitspeicher, Vektordatenbanken, gemeinsame Dokumente, Kundeneinträge oder interne Wissensdatenbanken.
Manipulierte Inhalte können über die ursprüngliche Interaktion hinaus bestehen bleiben. Der Agent ruft sie möglicherweise zu einem späteren Zeitpunkt erneut ab und behandelt sie als verlässliche Fakten. In einem Multi-Agenten-System kann sich der kompromittierte Kontext außerdem zwischen Arbeitsabläufen ausbreiten und einen Agenten mit höheren Berechtigungen beeinflussen.
Die KI-Lieferkette bildet eine weitere Angriffsfläche. Agenten hängen von Modellen, Orchestrierungsframeworks, Plugins, APIs, Datensätzen, Softwarepaketen und externen Diensten ab. Eine kompromittierte Komponente oder manipulierte Informationsquelle kann verändern, was der Agent für wahr hält, was er empfiehlt und welche Aktionen er ausführt.
Unternehmen sollten deshalb ein Inventar ihrer KI-Ressourcen pflegen, die Herkunft von Modellen und Werkzeugen prüfen und vertrauenswürdige Versionen festlegen. Abhängigkeiten müssen regelmäßig untersucht und externe Integrationen auf ungewöhnliches Verhalten überwacht werden.
## Eigene Identität und Prinzip der geringsten Berechtigung
Jeder in einer Produktivumgebung eingesetzte Agent sollte eine eigene, nachvollziehbare Identität besitzen. Agenten sollten keine persönlichen Konten, allgemeinen Dienstidentitäten oder langlebigen gemeinsamen Zugangsdaten verwenden.
Eine getrennte Identität ermöglicht es, einen Verantwortlichen zuzuordnen, spezifische Richtlinien durchzusetzen, Zugangsdaten zu erneuern, Vorfälle zu untersuchen und einen auffälligen Agenten schnell zu deaktivieren.
Berechtigungen müssen nach Rolle, Aufgabe, Datenquelle, Umgebung und Aktionstyp begrenzt werden. Ein Agent, der Kundenakten zusammenfasst, benötigt keinen unbegrenzten Schreibzugriff auf die gesamte Datenbank. Lese- und Schreibrechte sollten getrennt, möglichst kurzlebige Zugangsdaten eingesetzt und nicht mehr benötigte Berechtigungen entfernt werden.
Für Werkzeuge und APIs empfiehlt sich ein Modell, bei dem der Zugriff standardmäßig verweigert wird. Jede genehmigte Integration braucht eindeutige Eingabeschemata, Zugriffsgrenzen, Ratenbegrenzungen, Regeln zur Verarbeitung von Ergebnissen und vollständige Prüfprotokolle. Sensible Werkzeuge sollten hinter sicheren Vermittlungsschichten liegen, die jede Anfrage validieren, bevor sie das Zielsystem erreicht.
## Eingaben, Ausgaben und Speicher als nicht vertrauenswürdig behandeln
Informationen von Nutzern, Webseiten, E-Mails, Dokumenten oder externen Werkzeugen dürfen nicht automatisch als sicher gelten. Vertrauenswürdige Systemanweisungen müssen klar von externen Inhalten getrennt werden. Abgerufene Daten sind anhand ihrer Herkunft und der jeweiligen Nutzerberechtigungen zu bewerten.
Ebenso wichtig ist die Prüfung der Ausgaben. Vom Agenten erzeugte Inhalte können als Anweisung für eine Kommandozeile, einen Browser, einen SQL-Client, eine Kommunikationsplattform oder eine Geschäftsanwendung dienen. Parameter müssen vor der Ausführung anhand strenger Schemata und Sicherheitsrichtlinien kontrolliert werden. Destruktive, schwer umkehrbare oder extern sichtbare Aktionen sollten eine ausdrückliche Bestätigung erfordern.
Auch der Zugriff auf den persistenten Speicher muss begrenzt werden. Die Herkunft gespeicherter Informationen sollte dokumentiert, jeder neue Eintrag geprüft und nicht mehr benötigte Daten nach festgelegten Fristen gelöscht werden. Der Speicher eines Agenten ist ein potenziell angreifbarer Datenspeicher und keine automatisch vertrauenswürdige Wahrheitsquelle.
## Laufzeitüberwachung und menschliche Genehmigung
Tests vor der Bereitstellung können nicht jeden Weg vorhersehen, den ein autonomer Agent später wählt. Die Laufzeitüberwachung sollte Eingaben, abgerufenen Kontext, Berechtigungsprüfungen, Werkzeugaufrufe, Speicheränderungen, blockierte Aktionen, menschliche Freigaben und abschließende Operationen erfassen.
Ungewöhnliche Werkzeugfolgen, wiederholte Zugriffsverweigerungen, unerwartete externe Ziele, plötzliche Anstiege der Datenübertragung, Rechteänderungen oder Handlungen außerhalb des definierten Zwecks sollten Warnmeldungen auslösen. In besonders sensiblen Umgebungen muss es möglich sein, den Agenten sofort anzuhalten, seine Zugangsdaten zu widerrufen und einen unsicheren Ablauf zu beenden.
Nicht jede Aktion erfordert eine manuelle Prüfung. Routineaufgaben, die risikoarm und leicht umkehrbar sind, können automatisiert bleiben. Vorgänge, die Produktionsdaten, finanzielle Vermögenswerte, Zugriffsrechte, externe Kommunikation oder regulierte Informationen betreffen, sollten jedoch zusätzliche Kontrollen und eine menschliche Genehmigung erfordern.
Die Sicherheit von KI-Agenten verbindet letztlich Autonomie mit Verantwortlichkeit. Eindeutige Identitäten, minimale Berechtigungen, kontrollierte Werkzeuge, geschützter Kontext, kontinuierliche Überwachung und risikobasierte menschliche Freigaben bilden gemeinsam eine mehrschichtige Verteidigung.
KAEL AI veröffentlicht auf [Facebook](https://www.facebook.com/profile.php?id=61594050729769) und [X](https://x.com/KAELAI001) weiterhin praxisorientierte Einblicke in Agenten-Governance und vertrauenswürdige Automatisierung. Damit sollen Teams ihre Automatisierungsfähigkeiten ausbauen können, ohne auf Transparenz, Kontrolle oder Verantwortlichkeit zu verzichten.