
Actualités KAEL
Sécurité des agents d’IA : risques, contrôles et bonnes pratiques
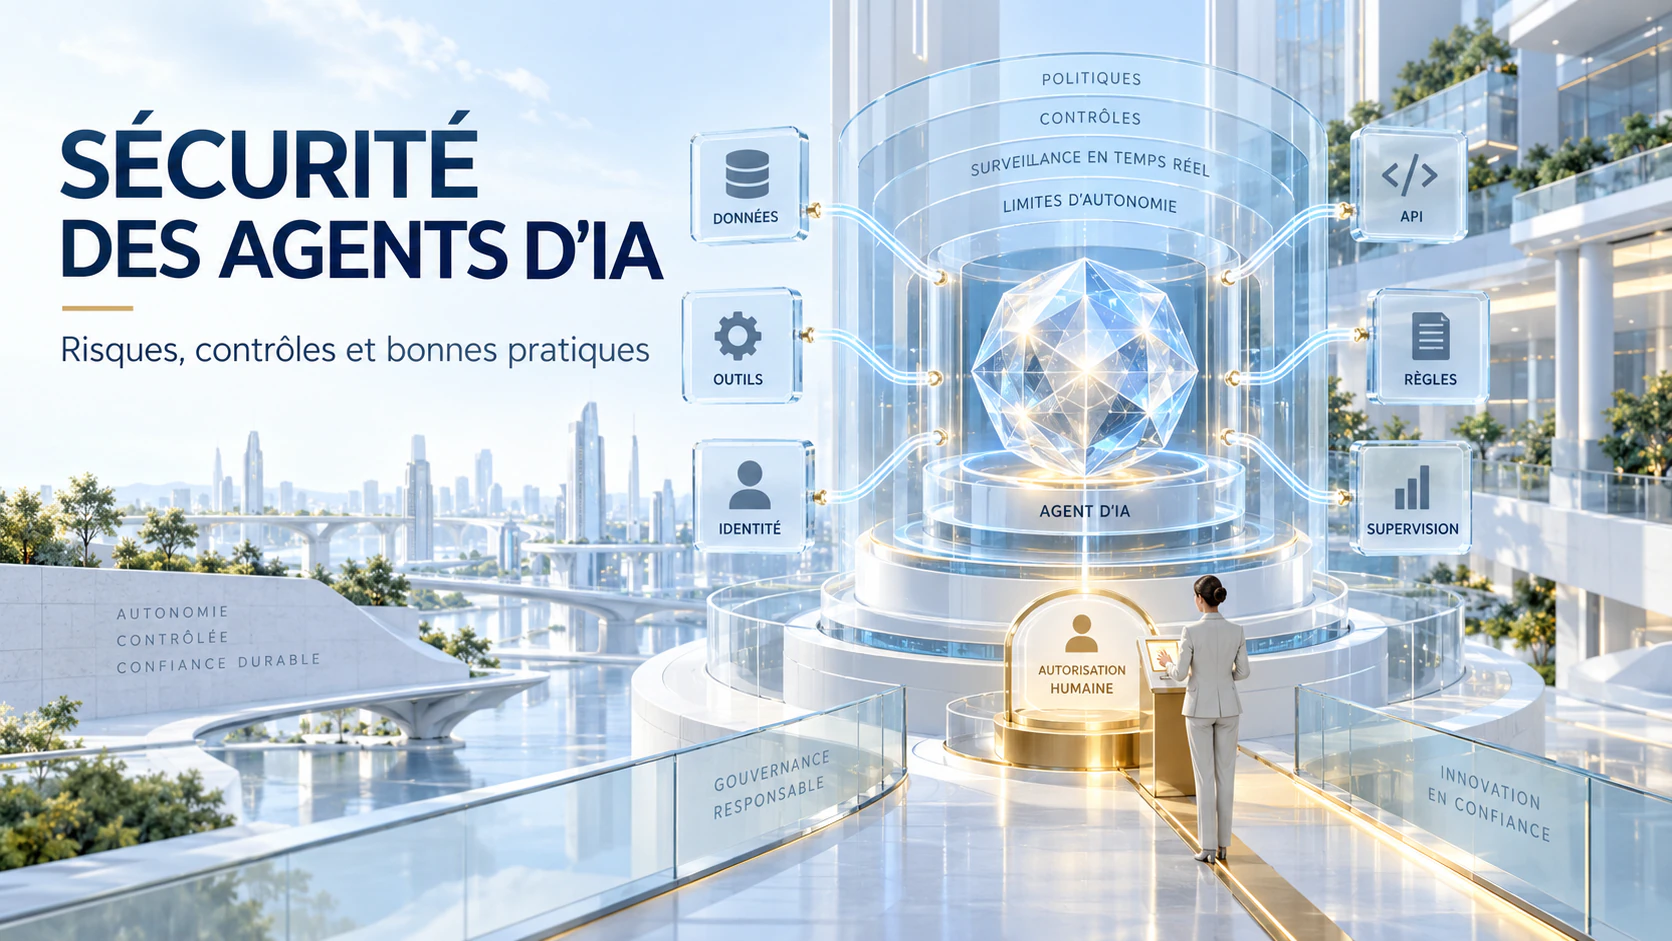
Les agents d’intelligence artificielle évoluent rapidement. Ils ne se contentent plus de répondre à des questions : ils peuvent interpréter des objectifs, élaborer des plans, accéder à des données, utiliser des outils logiciels et exécuter des actions pour le compte d’un utilisateur. Un agent peut analyser des documents, mettre à jour une fiche client, envoyer un message, modifier du code ou intervenir dans un processus financier.
Ces capacités créent une valeur opérationnelle considérable, mais elles augmentent également les conséquences potentielles d’une erreur, d’une manipulation ou d’un accès non autorisé. La sécurité des agents d’IA ne peut donc pas se limiter à vérifier les réponses produites par le modèle. Elle doit aussi protéger l’identité, les autorisations, les outils, la mémoire, les connexions aux données et le comportement de l’agent pendant son fonctionnement.
L’objectif n’est pas de supprimer toute autonomie, mais de créer une autonomie contrôlée. L’agent doit pouvoir travailler efficacement à l’intérieur de limites visibles, vérifiables et techniquement applicables.
## Pourquoi les agents d’IA nécessitent-ils des contrôles supplémentaires ?
Les applications traditionnelles suivent généralement des parcours définis à l’avance dans le code. Un agent d’IA peut, au contraire, interpréter le contexte et choisir dynamiquement les étapes ou les outils à utiliser. Des demandes similaires peuvent ainsi produire des plans, des résultats ou des actions différents.
Les mesures classiques, telles que l’authentification, l’autorisation, l’analyse des vulnérabilités, la protection du réseau et le développement sécurisé, restent indispensables. Cependant, les systèmes agentiques exigent aussi une protection des instructions en langage naturel, du contexte récupéré, de la mémoire persistante, du choix des outils et de l’exécution en plusieurs étapes.
Chaque nouvelle intégration élargit la surface d’attaque. Un agent connecté à la messagerie, au stockage cloud, aux dépôts de code, aux bases de données clients et aux systèmes financiers peut combiner ces accès d’une manière que ses concepteurs n’avaient pas anticipée.
La sécurité ne doit donc pas seulement déterminer si l’agent peut se connecter à un système. Elle doit également évaluer ce qu’il cherche à accomplir, quelles données il souhaite utiliser et si l’action envisagée correspond à sa mission autorisée.
## Les principaux risques de sécurité
L’injection d’instructions figure parmi les menaces les plus importantes. Un attaquant peut dissimuler une commande malveillante dans une demande directe, une page web, un courrier électronique, un document partagé, un ticket d’assistance ou un enregistrement de base de données.
Lorsque l’agent traite ce contenu, il peut confondre des données non fiables avec une instruction autorisée. Une attaque réussie pourrait l’amener à ignorer ses règles, révéler des informations protégées ou utiliser un outil en dehors du périmètre prévu. Le risque devient particulièrement sérieux lorsque l’agent peut exécuter des opérations réelles au lieu de simplement générer du texte.
Les autorisations excessives représentent un autre danger majeur. Pour simplifier un déploiement, une organisation peut accorder à l’agent des droits beaucoup plus étendus que ceux dont il a réellement besoin. Si cet agent est compromis ou prend une mauvaise décision, il pourrait consulter des dossiers confidentiels, modifier des données de production, envoyer une communication non autorisée ou déclencher une transaction.
L’utilisation incorrecte des outils transforme une erreur de raisonnement en dommage opérationnel. L’agent peut choisir le mauvais outil, transmettre des paramètres dangereux, agir au mauvais moment ou mal interpréter l’intention de l’utilisateur. Une réponse inexacte peut être corrigée ; une suppression de données ou une opération financière peut être beaucoup plus difficile à annuler.
Une fuite de données peut se produire si l’agent récupère des informations qui dépassent les droits de l’utilisateur, inclut un secret dans sa réponse, transmet un contexte confidentiel à un service externe ou conserve des données sensibles dans des journaux insuffisamment protégés. Puisque les agents relient plusieurs environnements, une information issue d’une source autorisée peut être envoyée accidentellement vers une destination non approuvée.
## Empoisonnement de la mémoire et chaîne d’approvisionnement
L’empoisonnement de la mémoire ou du contexte se produit lorsqu’un attaquant introduit des informations fausses ou malveillantes dans les sources qu’un agent utilisera pour prendre de futures décisions. La mémoire à long terme, les bases vectorielles, les documents partagés, les dossiers clients et les bases de connaissances peuvent être visés.
Le contenu manipulé peut survivre à l’interaction initiale. L’agent est susceptible de le retrouver ultérieurement et de le considérer comme une information fiable. Dans un système multi-agents, ce contexte compromis peut également se propager d’un processus à un autre et influencer un agent disposant de privilèges plus élevés.
La chaîne d’approvisionnement de l’IA constitue une autre surface d’attaque. Les agents dépendent de modèles, de cadres d’orchestration, de plugins, d’API, de jeux de données, de bibliothèques logicielles et de services tiers. Un composant compromis ou une source altérée peut modifier ce que l’agent considère comme vrai, ce qu’il recommande et les actions qu’il exécute.
Les organisations doivent maintenir un inventaire de leurs actifs d’IA, vérifier l’origine des modèles et des outils, fixer des versions de confiance et analyser régulièrement les dépendances. Le comportement des intégrations externes doit également être surveillé afin de détecter les anomalies.
## Identité distincte et principe du moindre privilège
Chaque agent utilisé en production doit disposer d’une identité distincte et traçable. Les agents ne devraient pas partager des comptes personnels, des identités de service génériques ou des identifiants valables pendant de longues périodes.
Une identité indépendante permet d’attribuer un responsable, d’appliquer des politiques précises, de renouveler les identifiants, d’enquêter sur un incident et de désactiver rapidement un agent qui se comporte de manière inattendue.
Les droits doivent être limités selon le rôle, la tâche, la source de données, l’environnement et le type d’action. Un agent chargé de résumer des dossiers clients n’a pas besoin d’un accès illimité en écriture à l’ensemble de la base. Il est préférable de séparer les permissions de lecture et d’écriture, d’utiliser des identifiants temporaires et de supprimer les autorisations devenues inutiles.
Les outils et les API devraient suivre un modèle de refus par défaut. Chaque intégration approuvée doit disposer de schémas d’entrée précis, de limites d’accès, de contrôles de fréquence, de règles de traitement des résultats et de journaux d’audit complets. Les outils sensibles doivent être placés derrière des passerelles sécurisées capables de vérifier chaque demande avant sa transmission au système cible.
## Considérer les entrées, les sorties et la mémoire comme non fiables
Les informations provenant d’un utilisateur, d’un site web, d’un courrier électronique, d’un document ou d’un outil externe ne doivent pas être considérées automatiquement comme sûres. Les instructions système fiables doivent être clairement séparées des contenus externes. Les données récupérées doivent être évaluées selon leur origine et selon les autorisations de l’utilisateur.
La validation des sorties est tout aussi importante. Un contenu généré par l’agent peut devenir une commande destinée à un terminal, un navigateur, un client SQL, une plateforme de messagerie ou une application métier. Les paramètres doivent être vérifiés à l’aide de schémas et de politiques stricts avant leur exécution. Les actions destructrices, irréversibles ou visibles à l’extérieur doivent exiger une confirmation explicite.
Il faut également limiter les utilisateurs et les processus autorisés à écrire dans la mémoire persistante. L’origine des informations stockées doit être enregistrée, les nouvelles entrées inspectées et les données devenues inutiles supprimées. La mémoire de l’agent est un stockage susceptible d’être attaqué, et non une source de vérité automatiquement fiable.
## Surveillance en temps réel et validation humaine
Les tests effectués avant le déploiement ne peuvent pas prévoir tous les chemins qu’un agent autonome choisira. La surveillance en temps réel doit couvrir les demandes, le contexte récupéré, les vérifications d’autorisation, les appels d’outils, les modifications de mémoire, les actions bloquées, les validations humaines et les opérations finales.
Des séquences inhabituelles d’outils, des refus d’accès répétés, des destinations externes inattendues, une hausse soudaine des transferts de données ou des actions étrangères à la mission de l’agent doivent déclencher une alerte. Dans les environnements à haut risque, il faut aussi pouvoir arrêter immédiatement l’agent, révoquer ses identifiants et interrompre un processus dangereux.
Toutes les actions ne nécessitent pas une révision manuelle. Les tâches répétitives, réversibles et à faible risque peuvent rester automatisées. En revanche, les opérations qui touchent aux données de production, aux actifs financiers, aux autorisations, aux communications externes ou aux informations réglementées doivent être soumises à des contrôles supplémentaires et à une validation humaine.
La sécurité des agents d’IA consiste finalement à associer autonomie et responsabilité. Une identité claire, le moindre privilège, des outils contrôlés, un contexte protégé, une surveillance continue et une approbation humaine adaptée au niveau de risque forment une défense à plusieurs niveaux.
KAEL AI continue de partager des perspectives pratiques sur la gouvernance des agents et l’automatisation fiable via [Facebook](https://www.facebook.com/profile.php?id=61594050729769) et [X](https://x.com/KAELAI001), afin d’aider les équipes à développer leurs capacités d’automatisation sans renoncer à la visibilité, au contrôle ou à la responsabilité.